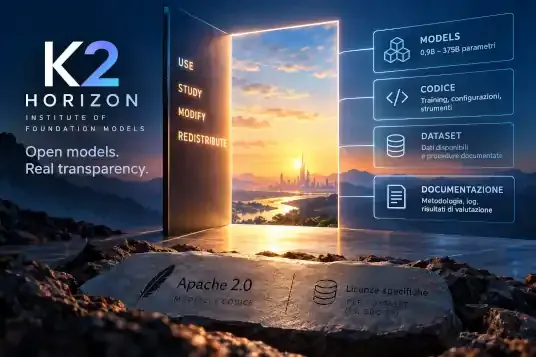
Nel dibattito sull’Intelligenza Artificiale si utilizza ormai con grande facilità la parola “open”. Si parla di modelli open source, open weight, modelli aperti e IA libera, spesso mettendo sullo stesso piano realtà molto diverse. Ma avere la possibilità di scaricare i pesi di un modello significa davvero avere un’Intelligenza Artificiale aperta?
Il rilascio di K2 Horizon, avvenuto il 3 settembre 2026 da parte dell’Institute of Foundation Models (IFM) della Mohamed bin Zayed University of Artificial Intelligence, offre un caso particolarmente interessante sul quale ragionare.
K2 Horizon non è un singolo modello, ma una famiglia composta da sei foundation model di dimensioni molto diverse: 0,9B, 3,7B, 7B, 32B, 36B-A4B e 375B-A23B. Si passa quindi da modelli relativamente piccoli, pensati anche per dispositivi con risorse limitate, fino a un modello di grandi dimensioni destinato a compiti complessi e ad ambienti enterprise.
Ma l'aspetto che ci interessa maggiormente non riguarda le prestazioni dichiarate dei modelli. Riguarda la loro apertura.
Non soltanto i pesi
Molti modelli definiti genericamente “open” permettono di scaricare i pesi già addestrati. È certamente un passo importante, perché consente di eseguire il modello autonomamente, studiarne almeno in parte il comportamento, adattarlo attraverso fine-tuning e costruire applicazioni senza dipendere necessariamente dai servizi API del produttore.
Ma i pesi raccontano soltanto il risultato finale.
Per comprendere realmente come un modello è stato costruito servono molte altre informazioni: il codice utilizzato per l’addestramento, l’architettura, i dati o almeno la loro provenienza e le procedure con cui sono stati selezionati, le configurazioni, i checkpoint intermedi, i criteri di valutazione e la metodologia utilizzata durante le diverse fasi dell’addestramento.
È precisamente su questo terreno che K2 Horizon diventa particolarmente interessante.
IFM dichiara di avere aperto l’intero ciclo di training, dal pretraining alle successive fasi di reasoning e agentic post-training. Il progetto mette a disposizione, secondo la documentazione pubblicata, pesi finali, checkpoint intermedi, codice di training, configurazioni, log dettagliati, risultati delle valutazioni, informazioni sull’architettura e sulla composizione dei dati. Per i dataset vengono distribuiti i dati quando ciò è possibile oppure, quando le condizioni delle fonti non ne consentono la redistribuzione, vengono documentate le procedure utilizzate per costruirli e combinarli.
Questa differenza è fondamentale.
Un modello del quale possiamo soltanto scaricare i pesi può essere utilizzabile e modificabile, ma rimane molto difficile ricostruire completamente il processo che lo ha prodotto. Rendere disponibile anche una parte sostanziale del processo di addestramento significa invece avvicinarsi molto di più al principio della riproducibilità scientifica.
La scelta di Apache 2.0
I modelli e il codice di K2 Horizon sono distribuiti sotto licenza Apache 2.0, una delle licenze permissive più utilizzate nel mondo del Software Libero e Open Source.
La scelta è significativa perché Apache 2.0 concede ampie possibilità di utilizzo, modifica e redistribuzione, compreso l'impiego commerciale. Non impone però un principio di copyleft analogo a quello che caratterizza licenze come la GNU GPL o, in un contesto differente, la GNU AGPL.
Ed è proprio qui che nasce una questione interessante.
Una licenza permissiva garantisce una grande libertà a chi riceve oggi il modello, ma non necessariamente garantisce la stessa apertura a chi riceverà domani un prodotto derivato da quel modello.
Un'impresa può quindi prendere una tecnologia aperta, modificarla, integrarla in un proprio prodotto e costruire sopra di essa componenti proprietarie senza essere obbligata, per il solo effetto della licenza Apache 2.0, a restituire alla comunità tutte le modifiche apportate.
Non si tratta di un difetto nascosto della licenza: è esattamente la filosofia delle licenze permissive. Ed è una scelta che ha favorito enormemente la diffusione di moltissimo Software Libero.
La domanda interessante è un'altra: questo modello è sufficiente anche per l'Intelligenza Artificiale?
Le quattro libertà e l'Intelligenza Artificiale
Il Software Libero ha costruito storicamente la propria identità attorno a libertà relativamente facili da individuare: eseguire il programma, studiarlo, modificarlo e redistribuirlo, comprese le versioni modificate.
Con un grande modello di IA la situazione diventa molto più complessa.
Qual è, infatti, l'equivalente del “codice sorgente” di un LLM?
Il codice che definisce l'architettura? I pesi? Il codice utilizzato per il training? I dataset? I parametri di configurazione? I checkpoint intermedi? Le procedure di filtraggio dei dati? Le tecniche utilizzate nel post-training?
Probabilmente nessuno di questi elementi, preso isolatamente, è sufficiente.
Se posso scaricare i pesi ma non conosco i dati utilizzati per produrli, possiedo davvero la possibilità di studiare il sistema? Se conosco l'architettura ma non posso riprodurre il training, posso realmente parlare della stessa libertà che abbiamo nel Software Libero? E se posso utilizzare liberamente un modello ma non posso sapere attraverso quali dati e quali decisioni sia stato costruito, quanto è effettiva la possibilità di verificarlo?
K2 Horizon ha il merito di rendere queste domande molto più concrete.
Open source, open weight e IA realmente aperta non sono la stessa cosa
Da qui nasce anche la necessità di utilizzare con maggiore precisione le parole.
Un modello open weight, del quale sono disponibili essenzialmente i pesi, non dovrebbe essere automaticamente considerato equivalente a un progetto nel quale sono disponibili anche codice, dati, metodologie e strumenti necessari alla riproduzione.
La distinzione non è terminologica ma sostanziale.
Se l'Intelligenza Artificiale sta diventando un'infrastruttura fondamentale della società, poterla semplicemente utilizzare non basta. Diventa importante poter sapere come è stata costruita, con quali dati, attraverso quali procedure e secondo quali criteri è stata valutata.
Ed è precisamente sotto questo profilo che l'esperimento K2 Horizon merita attenzione.
Apache 2.0 basta?
Rimane però aperta una questione ancora più profonda.
Apache 2.0 garantisce grandi libertà nell'utilizzo dell'opera distribuita, ma non obbliga chi costruisce un derivato a mantenere lo stesso grado di apertura. È quindi perfettamente possibile che una risorsa nata aperta diventi la base tecnologica di sistemi successivi molto meno trasparenti.
Il problema non riguarda soltanto K2 Horizon. Riguarda l'intero futuro delle licenze applicate all'Intelligenza Artificiale.
Le licenze nate per il software sono state progettate in un mondo nel quale il “sorgente” poteva essere identificato con relativa precisione. Nei sistemi di IA contemporanei abbiamo invece una catena molto più articolata:
codice → dati → procedure di preparazione → addestramento → checkpoint → pesi → post-training → modello finale.
Garantire soltanto l'apertura di uno degli anelli potrebbe non essere sufficiente a garantire l'apertura dell'intero processo.
Potrebbe quindi essere necessario sviluppare, o perfezionare, strumenti giuridici e culturali capaci di tradurre nel mondo dell'IA lo spirito originario del Software Libero: non soltanto la possibilità di usare una tecnologia, ma anche quella di studiarla, comprenderla, modificarla, riprodurla e condividere realmente la conoscenza necessaria a costruirla.
K2 Horizon come esperimento da osservare
K2 Horizon non risolve definitivamente questo problema e sarebbe prematuro presentarlo come il modello ideale dell'IA libera. Offre però qualcosa di molto importante: un caso concreto sul quale misurare la distanza tra un semplice modello “open weight” e un ecosistema nel quale viene resa pubblica una parte molto più ampia del processo di produzione dell'Intelligenza Artificiale.
Ed è forse questa la parte più interessante dell'intero progetto.
La vera discussione dei prossimi anni potrebbe infatti non essere più semplicemente se un modello sia “open source” oppure proprietario, ma che cosa debba essere reso disponibile affinché una Intelligenza Artificiale possa essere considerata realmente libera, verificabile e riproducibile.
K2 Horizon propone una risposta molto più avanzata rispetto al semplice rilascio dei pesi, ma lascia aperta la questione del copyleft e della libertà dei derivati.
Ed è una questione tutt'altro che teorica.
Se l'Intelligenza Artificiale diventerà una delle infrastrutture fondamentali attraverso cui produciamo conoscenza, informazione, software, ricerca e servizi pubblici, allora decidere chi può studiarla, chi può modificarla, chi può riprodurla e chi può controllarne i mezzi di produzione diventerà una delle grandi questioni tecnologiche e democratiche del nostro tempo.